Cómo llevar un proyecto de AI a producción: guía y checklist
Tu demo de AI funciona. El asistente responde bien, el equipo aplaude y alguien pregunta si pueden lanzarlo el lunes. Ahí empieza el trabajo de verdad: llevar un proyecto de AI a producción no consiste en copiar el prototipo a un servidor más grande, sino en convertir un experimento en un sistema que alguien opera, mide y mejora todos los días, incluso cuando los datos cambian y el modelo se equivoca.
Esta guía recorre ese camino con apoyo de la masterclass gratuita que tuvimos en Henry con Alexander Vicondoa, Head of Deployment en ElevenLabs y durante seis años Gen AI Director en Mercado Libre. Al final encontrarás un checklist de 10 preguntas para revisar tu propio proyecto.
Qué cambia al llevar un proyecto de AI a producción
Un prototipo responde una pregunta: ¿esto es posible? Producción responde otra: ¿esto se sostiene todos los días, con usuarios reales y sin que sus creadores lo vigilen? La masterclass arranca justo ahí y explica por qué tantos proyectos de AI se quedan en la demo.
La respuesta corta es que casi nunca falla el modelo. Falla todo lo que lo rodea. En un prototipo tú eliges los ejemplos que lucen bien, corriges a mano lo que sale mal y lo usan pocas personas con tu acompañamiento. En producción llegan datos incompletos, usuarios que preguntan cosas que nadie imaginó, integraciones con sistemas existentes y expectativas de servicio.
Un sistema está realmente en producción cuando funciona día a día sin depender de quienes lo construyeron. Si tu sistema se cae cuando el equipo original se va de vacaciones, todavía es un prototipo con más usuarios.
Mira la Masterclass «Cómo llevar un prototipo de AI a producción», con Alexander Vicondoa.
Resumen del vídeo de la masterclass
En la sesión, Alexander Vicondoa construyó en vivo un agente para renovar la licencia de conducir en Argentina, un trámite que suele atenderse con chatbots de texto que no guían bien y obligan a repetir la gestión. Lo desarrolló en cuatro actos, apoyándose en una herramienta de coding con agentes para generar el código:
- Acto 1: API con contrato. Se crea la conexión con el LLM y se define con Pydantic el formato de la respuesta: una categoría, las acciones posibles y un nivel de confianza. Después se arma un dataset de consultas etiquetadas y un evaluador que mide qué tan bien clasifica cada intención. Como el LLM no es determinístico, esas pruebas se repiten cada vez que cambia el agente, el prompt o las herramientas. Según Alexander, sin evals es muy difícil controlar lo que hace un agente.
- Acto 2: RAG. Ante la consulta «se me venció hace 3 años», el sistema sin base de conocimiento daba una respuesta vaga que mandaba a confirmar la normativa. Después de cargar normativa y preguntas frecuentes, fragmentarlas (chunking) y generar embeddings con búsqueda híbrida en un entorno local, respondió con la regla concreta (más de 90 días vencida exige examen teórico y práctico), citó la fuente y su confianza subió de 0.6 a 1.
- Acto 3: herramientas y agente. Se crean tres herramientas: consultar el calendario de turnos, agendar un turno con nombre, email y horario, y validar el correo. Un bucle de agente escrito a mano, con function calling y un tope de seis pasos para que no entre en ciclos, las usa para completar la gestión. Los evals del primer acto sirven para validar que todo siga funcionando.
- Acto 4: voz. El backend se protege con un token, se expone mediante un túnel y se conecta a ElevenLabs. En la demo, la agente «Renata» explica los requisitos de una licencia vencida hace seis meses, ofrece turnos, pide nombre y email, y confirma el turno.
Arquitectura de un sistema de AI: LLMs, RAG y agentes
La buena noticia es que casi nunca entrenas un modelo desde cero. Construyes sobre modelos existentes, a los que accedes por API, y tu trabajo está en cómo los conectas con tus datos y tus procesos. Esa arquitectura se apoya en tres piezas, de la más simple a la más compleja:
- LLM (el modelo): genera o razona sobre texto. Lo eliges según calidad, latencia y costo; una tarea simple no necesita el modelo más grande.
- RAG (Retrieval-Augmented Generation): antes de responder, el sistema busca en tus documentos los fragmentos relevantes y se los entrega al modelo como contexto. Así responde con datos reales y vigentes, y puede citar la fuente en lugar de improvisar.
- Agentes: un LLM con herramientas (consultar una API, buscar en una base de datos, escribir en un CRM) que decide qué hacer paso a paso para completar una tarea.
Piensa en un asistente interno al que preguntan por la política de reembolsos. Con un LLM solo, responde con lo que "recuerda" del entrenamiento y puede inventar. Con RAG, busca el documento vigente y responde citándolo. Con un agente, además puede abrir el ticket del cliente y registrar la respuesta.
La regla práctica es empezar por la opción más simple que resuelva el problema: primero un buen prompt, después RAG cuando necesites tus propios datos, y agentes solo cuando la tarea exija decidir varios pasos. Cada nivel suma capacidad, pero también latencia, costo y puntos donde algo puede fallar.
🚀 Diseñar y desplegar este tipo de sistemas es el trabajo de un AI Engineer, y es una de las áreas centrales de la carrera de AI Engineering de Henry.
Paso a paso para llevar tu proyecto de AI a producción
Esta es la secuencia de la masterclass, ampliada con lo que exige operar un sistema real. Los conceptos ya están explicados arriba; aquí va lo que debes dejar resuelto en cada paso.
1. Define un contrato de API
Establece qué recibe y qué devuelve tu sistema con estructuras validadas, como un JSON con esquema. Así el resto de la aplicación no depende de respuestas ambiguas, y puedes detectar de forma automática cuando el modelo se sale del formato.
2. Conecta tus datos con RAG
Lleva tus documentos al sistema: límpialos, fragméntalos (chunking), conviértelos en embeddings y guárdalos en una base vectorial. En producción se suma una tarea que el prototipo no tiene: reindexar cuando los documentos cambien, porque un RAG con información vencida responde con seguridad algo falso.
3. Agrega herramientas con límites claros
Dale al agente acciones concretas (consultar un calendario, validar un dato, agendar) y acota lo que puede hacer. Cada herramienta es un punto de fallo nuevo: valida sus entradas, decide qué ocurre cuando falla y limita la cantidad de pasos que el agente puede encadenar, como hizo Alexander con su tope de seis, para que no quede en un ciclo.
4. Construye tus evals antes de lanzar
Reúne casos reales, entradas problemáticas y casos límite, y ejecútalos con cada cambio. Define también tu presupuesto de error. El detalle está en la siguiente sección.
5. Activa la observabilidad
Registra cada ejecución para poder reconstruir qué pasó cuando alguien reporte un error. También se explica abajo.
6. Calcula el costo y nombra un responsable
El costo de un agente se compone de los tokens del LLM, la infraestructura que lo soporta y, si usas voz, el costo por minuto. Para estimar el costo por tarea, multiplica los tokens de entrada y salida de cada llamada por las llamadas que hace la tarea (RAG y agentes encadenan varias) y por el volumen mensual esperado. Hazlo con el volumen real, no con el de la demo. Y asigna una persona responsable del servicio: quien responde cuando la calidad baja, decide si se revierte un cambio y mantiene los documentos al día.
Cómo medir si tu sistema de AI funciona: evaluación y observabilidad
Para verificar que el sistema funcione hay que seguir dos prácticas: evaluar antes y durante, y observar siempre.
Evaluación (evals). Es un conjunto de casos representativos con el resultado esperado o con criterios para juzgarlo. Incluye preguntas reales, entradas problemáticas y casos límite. Lo ejecutas cada vez que cambias el prompt, el modelo o los documentos, igual que corres tests antes de desplegar código. Se combinan tres tipos de chequeo:
- Reglas determinísticas, como que el formato sea válido o que la respuesta cite una fuente.
- Comparación contra una respuesta de referencia.
- Un modelo que actúa como juez con una rúbrica, calibrado contra revisión humana.
Dos precauciones. Primero, mide por segmento y no solo el promedio: un buen resultado global puede esconder que el sistema falla casi siempre en un tipo de consulta poco frecuente pero crítico. Segundo, define de antemano tu "presupuesto de error": el nivel de fallo que aceptas y la lista de errores que nunca son tolerables.
Observabilidad. Es la capacidad de reconstruir qué pasó en cada ejecución: la pregunta, los documentos recuperados, la versión del prompt, la respuesta, la latencia, los tokens consumidos y el feedback del usuario. Si un usuario reporta una respuesta mala, con la traza ves en minutos si falló la búsqueda (RAG trajo el documento equivocado) o la generación (el modelo ignoró un documento correcto). Sin trazas, solo puedes adivinar. Suma alertas por caída de calidad, picos de latencia y aumento del costo por consulta.
Checklist: ¿está tu proyecto de AI listo para producción?
Responde sí o no a cada pregunta. Cada "no" es un riesgo concreto que conviene cerrar antes del lanzamiento.
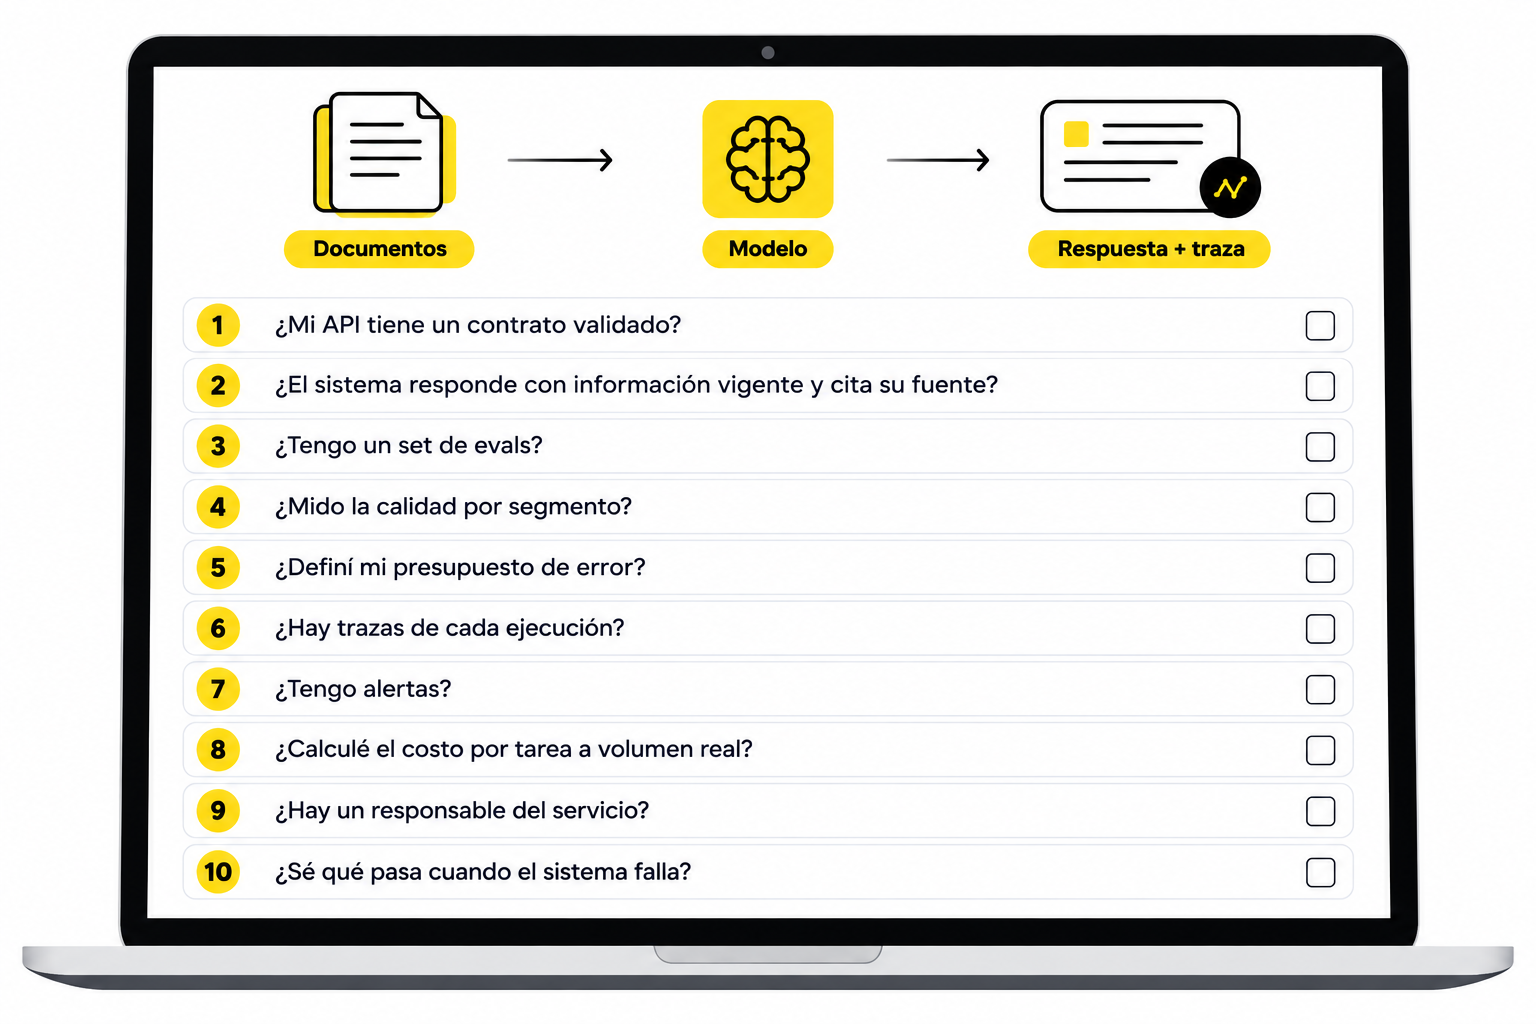
- ¿Mi API tiene un contrato validado? Entradas y salidas estructuradas, con validación automática del formato.
- ¿El sistema responde con información vigente y cita su fuente? Y existe un proceso para reindexar los documentos cuando cambian.
- ¿Tengo un set de evals? Con preguntas reales, entradas problemáticas y casos límite, ejecutado en cada cambio de prompt, modelo o documentos.
- ¿Mido la calidad por segmento? No solo el promedio global, sobre todo en las consultas poco frecuentes pero críticas.
- ¿Definí mi presupuesto de error? El nivel de fallo aceptable y la lista de errores que nunca son tolerables.
- ¿Hay trazas de cada ejecución? Pregunta, contexto recuperado, versión del prompt, respuesta, latencia, tokens y feedback.
- ¿Tengo alertas? Por caída de calidad, picos de latencia y aumento del costo por consulta.
- ¿Calculé el costo por tarea a volumen real? Incluyendo todas las llamadas que encadena cada tarea.
- ¿Hay un responsable del servicio? Una persona con nombre, no "el equipo".
- ¿Sé qué pasa cuando el sistema falla? Un plan de respaldo, como derivar a una persona o desactivar una herramienta, y la capacidad de operar sin depender de quienes lo construyeron.
Preguntas frecuentes sobre llevar AI a producción
¿Por qué fallan los proyectos de AI al pasar de prototipo a producción?
Suelen fallar por el sistema que rodea al modelo, no por el modelo. Las causas típicas son que no existe un conjunto de evaluación, que no hay trazas para diagnosticar errores, que nadie es responsable del servicio y que el costo a volumen real nunca se calculó.
¿Cómo sé si mi proyecto de AI está listo para producción?
Cuando puedes responder "sí" al checklist de esta guía: contrato de API, información vigente, evals, trazas, costos calculados y un responsable. La señal de fondo es que funcione sin depender de quienes lo construyeron.
¿Qué es RAG y cuándo conviene usarlo?
RAG (Retrieval-Augmented Generation) conecta un LLM con tus documentos: busca los fragmentos relevantes y los usa como contexto antes de responder. Conviene cuando el sistema debe responder con información propia o que cambia con frecuencia, porque actualizas los documentos sin reentrenar el modelo.
¿Qué es la observabilidad en un sistema de AI?
Es registrar y analizar cada ejecución (entrada, contexto, versión del prompt, salida, latencia y costo) para entender por qué el sistema respondió como respondió y detectar a tiempo si su calidad se degrada.
¿Qué hace un AI Engineer?
Diseña, evalúa y despliega sistemas de AI sobre modelos existentes. Integra LLMs, RAG y agentes con los datos y procesos de una organización, y se ocupa de que funcionen de forma confiable en producción.
💥 Este recorrido de diseñar la arquitectura, evaluar, observar y desplegar es trabajo cotidiano de un AI Engineer. Si ya programas y quieres aprender a construir y llevar a producción sistemas con LLMs, RAG y agentes, conoce la carrera de AI Engineering de Henry. Y si quieres ver el recorrido completo, mira la masterclass con Alexander Vicondoa.