Qué es RAG y cómo funciona, paso a paso
Le preguntas a un chatbot por la política de vacaciones de tu empresa y te responde con una frase bien redactada, segura y con un dato que nadie escribió en ningún documento. Ese problema, que el modelo invente cuando no sabe, es uno de los más difíciles de resolver al construir AI para empresas. Resolverlo es, en gran parte, el trabajo de un AI Engineer, y la técnica que más se usa para lograrlo se llama RAG. RAG (Retrieval-Augmented Generation) hace que el modelo busque primero la información relevante en tus documentos y responda solo con ese contexto, en lugar de inventar.
Por qué un modelo de lenguaje solo no alcanza
Un modelo de lenguaje aprende de enormes cantidades de texto hasta una fecha de corte. Después de eso, no sabe nada nuevo. Tampoco conoce los documentos internos de tu empresa, tus tickets de Jira ni tu wiki privada. Y cuando no tiene una respuesta, en lugar de decir que no sabe, tiende a generar texto que suena plausible. A eso lo llamamos alucinar.
Podrías pensar en pegar toda la documentación en el prompt. Funciona con poca información, pero cada modelo tiene un límite de texto que puede procesar a la vez, la respuesta se vuelve lenta y costosa, y el modelo pierde precisión cuando recibe demasiado contexto. Reentrenar o hacer fine-tuning con tus datos tampoco es la solución ideal, porque cada vez que una política cambia, tendrías que repetir el proceso.
RAG resuelve esto de otra manera: en lugar de depender de la memoria del modelo, le da acceso a la información correcta en el momento de responder.
Cómo funciona RAG: el examen de libro abierto
RAG tiene tres pasos: retrieval, augmentation y generation. Primero, el sistema busca en una base de datos los fragmentos de información relevantes para la pregunta. Después, esos fragmentos se suman al prompt junto con la pregunta del usuario. Por último, el modelo redacta la respuesta usando solo ese contexto.
Puedes pensarlo como un examen de libro abierto. Un modelo sin RAG es un estudiante que responde de memoria, y a veces inventa. Con RAG, el estudiante tiene el libro abierto en la página correcta, y su trabajo es leer bien y responder con precisión.
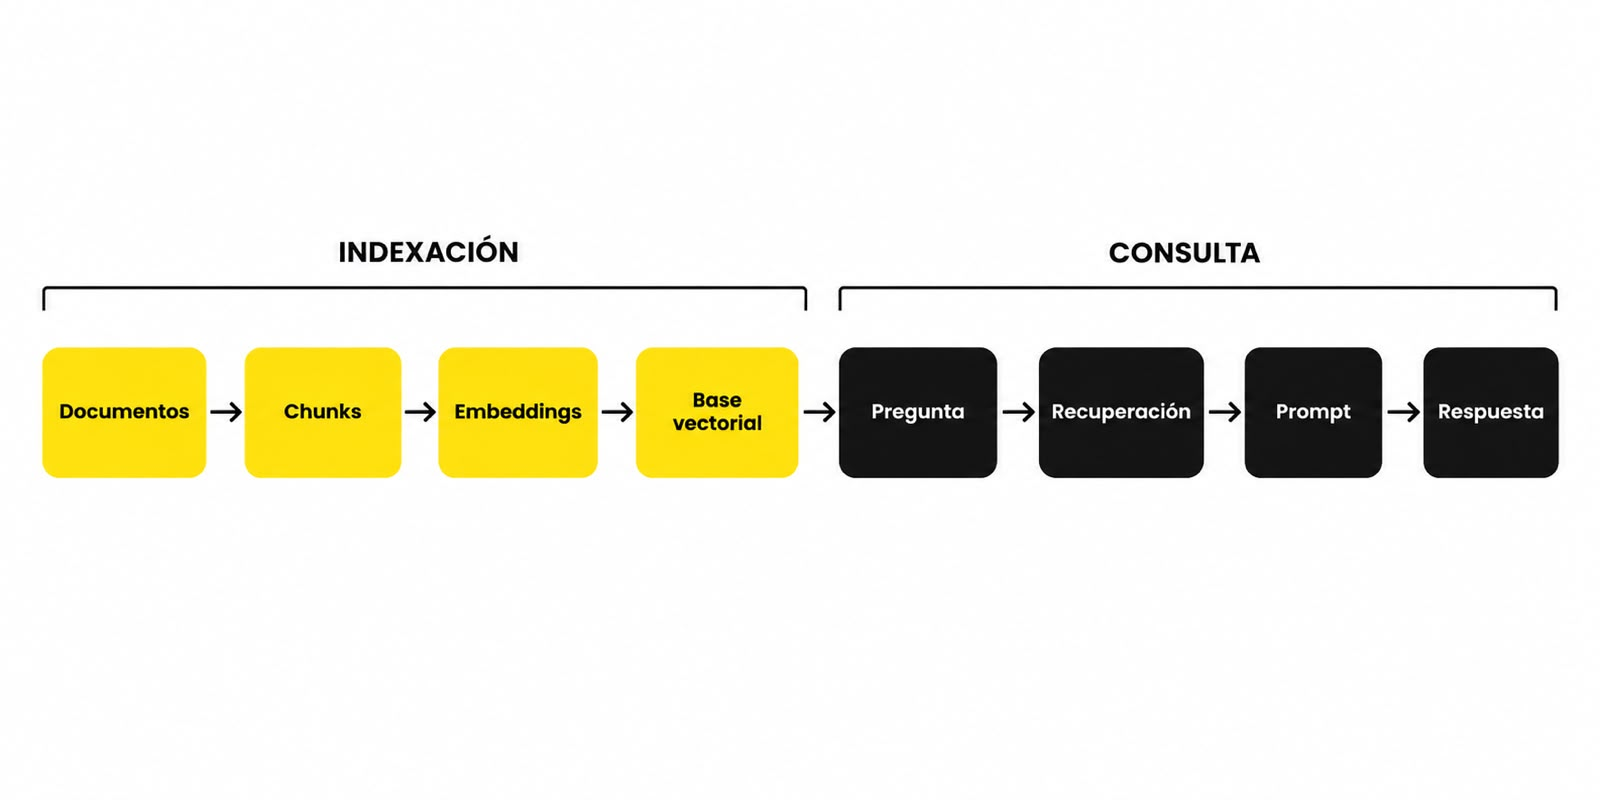
Para que esto funcione, los documentos se dividen en chunks, fragmentos de unos cientos a unos mil tokens, porque recuperar un libro entero no sirve de nada. Cada chunk se convierte en un embedding, una lista de números que representa su significado. Esos vectores se guardan en una base vectorial, como ChromaDB o Pinecone, o en una librería de búsqueda como FAISS. Cuando llega una pregunta, se transforma en un vector con el mismo modelo, y el sistema busca los chunks cuyos vectores están más cerca. Esa cercanía matemática se traduce en similitud de significado.
El proceso completo tiene dos fases. La indexación ocurre una vez, o cada vez que cambian los documentos:
- Cargar los documentos.
- Dividirlos en chunks.
- Generar los embeddings.
- Guardarlos en una base vectorial.
La consulta ocurre cada vez que un usuario hace una pregunta:
- Convertir la pregunta en un vector.
- Buscar los chunks más cercanos.
- Armar el prompt con ese contexto.
- Generar la respuesta.
Un RAG básico en código
El ejemplo usa Python, ChromaDB para la base vectorial y el SDK de Anthropic para generar la respuesta. Esto asume que tienes Python 3.10 o superior, que instalaste los paquetes con pip install chromadb anthropic, y que tu API key está en la variable de entorno ANTHROPIC_API_KEY. La primera vez, ChromaDB descarga su modelo de embeddings por defecto.
python
import chromadb
from anthropic import Anthropic

def chunk_text(text, words_per_chunk=200, overlap=40):
    # Cortamos por palabras como aproximación a tokens (1 token ≈ 0,75 palabras)
    words = text.split()
    step = words_per_chunk - overlap
    chunks = []
    for start in range(0, len(words), step):
        chunks.append(" ".join(words[start:start + words_per_chunk]))
    return chunks

# 1. Indexación: se hace una vez, o cuando cambian los documentos
with open("politicas_rh.txt", encoding="utf-8") as f:
    document = f.read()

chunks = chunk_text(document)

db = chromadb.Client()  # base en memoria, para el prototipo
collection = db.create_collection("politicas")
collection.add(
    ids=[f"chunk-{i}" for i in range(len(chunks))],
    documents=chunks,  # Chroma genera los embeddings automáticamente
)

# 2. Consulta: se hace cada vez que llega una pregunta
question = "¿Cuántos días de vacaciones tengo al año?"
results = collection.query(query_texts=[question], n_results=3)
context = "\n\n".join(results["documents"][0])

# 3. Prompt y generación de la respuesta
llm = Anthropic()  # toma ANTHROPIC_API_KEY del entorno
response = llm.messages.create(
    model="claude-haiku-5-5",
    max_tokens=500,
    system="Responde solo con la información del contexto. Si la respuesta no está ahí, dilo.",
    messages=[
        {"role": "user", "content": f"Contexto:\n{context}\n\nPregunta: {question}"}
    ],
)
print(response.content[0].text)
El solapamiento entre chunks evita cortar ideas a la mitad, y limitar la cantidad de fragmentos recuperados (n_results=3) mantiene el prompt claro. Junto con el tamaño del chunk, son los primeros parámetros que un AI Engineer ajusta cuando el sistema no responde bien.
Qué problemas aparecen en producción
Armar un RAG que funcione en una demo es relativamente sencillo. Hacer que funcione bien con miles de documentos reales es otro desafío.
Los chunks mal diseñados son una fuente frecuente de errores. Si son muy grandes, incluyen información irrelevante. Si son muy chicos, pierden contexto. Otro problema es la recuperación irrelevante: la búsqueda semántica a veces trae fragmentos que suenan parecidos pero no responden la pregunta. Por eso muchos sistemas combinan búsqueda semántica con búsqueda por palabras clave, sobre todo cuando hay códigos, nombres propios o números de expediente.
Las alucinaciones también pueden aparecer aunque el modelo tenga contexto. Un prompt que indique que solo use la información recuperada y que admita cuando no sabe reduce mucho el riesgo, pero no lo elimina. Ahí entran las evals: suites de pruebas que miden si el sistema responde bien, detectan regresiones cuando cambia un prompt o un modelo y señalan cuándo una respuesta no tiene respaldo en los documentos.
Por último, los datos cambian. Si una política se actualiza y el índice no se regenera, el sistema responde con información vieja. Por eso se diseñan procesos que detectan cambios en los documentos y actualizan los vectores automáticamente.
Qué hace un AI Engineer con RAG
Un AI Engineer toma modelos existentes y los convierte en sistemas que funcionan en producción. Eso implica diseñar la recuperación, escribir prompts que reduzcan errores, conectar el modelo con herramientas externas, construir agentes que ejecutan tareas en varios pasos y, sobre todo, evaluar y monitorear. Un sistema desplegado necesita controlar costos, latencia y calidad de las respuestas, y sin esa parte una demo puede verse impresionante y fallar con usuarios reales.
El mercado lo refleja. Según el ranking Jobs on the Rise 2026 de LinkedIn, que analiza millones de puestos iniciados por sus miembros entre enero de 2023 y julio de 2025, AI Engineer ocupa el primer lugar entre los roles de mayor crecimiento. Dentro de ese trabajo, las tareas suelen repartirse entre quienes diseñan la recuperación, quienes escriben las pruebas que detectan alucinaciones y regresiones, y quienes diseñan agentes y su memoria.
Cómo seguir aprendiendo AI Engineering
Lo que separa una demo de un sistema real es practicar con casos completos: un RAG sobre tus propios documentos, un agente que consulta bases de datos y una evaluación que mide si todo funciona. Ese tipo de proyecto es lo que te permite mostrar en una entrevista qué sabes hacer.
La carrera de AI Engineering de Henry está pensada para desarrolladores que ya tienen experiencia programando y quieren pasar al siguiente nivel técnico con AI. Dura 14 semanas en modalidad part time, con dos clases en vivo por semana, y el recorrido va de los LLMs y el context engineering a RAG, agentes, despliegue en producción y evaluación. El hilo conductor es la evaluación: medir y testear lo que construyes desde la primera semana. Las herramientas incluyen Python, Claude, OpenAI, LangChain y LangGraph, bases vectoriales, MCP, FastAPI, Docker y stacks de evals como Promptfoo, Giskard y Langfuse.
Puedes ver el programa completo y los requisitos en la página de AI Engineering en Henry.
Preguntas frecuentes
¿Qué conocimientos previos necesito para la carrera de AI Engineering?
La carrera está pensada para personas con al menos tres años programando en backend, full-stack o data. Se espera manejo de Python y de un segundo lenguaje, SQL, APIs REST, Git y experiencia con al menos una nube. El inglés para leer documentación técnica es deseable, aunque no excluyente. No es un curso para quien empieza de cero.
¿Cuánto dura la carrera y cómo se organiza?
Son 14 semanas en total, en modalidad part time. Incluyen un módulo 0 de nivelación, de carácter asincrónico, que se realiza antes del inicio de la cohorte. Después, hay dos clases en vivo por semana, los martes y jueves de 20 a 22 h.
¿Qué proyectos voy a construir?
Trabajas en un proyecto integrador que crece a lo largo de los primeros tres módulos, con RAG, agentes y evaluaciones. El último módulo incluye un proyecto final: un sistema desplegado con guardrails, observabilidad e interfaz de voz, que se defiende en una instancia técnica individual.
¿Qué diferencia hay entre RAG y fine-tuning?
RAG consulta información externa en el momento de responder y la incluye en el prompt. El fine-tuning ajusta los pesos del modelo con ejemplos adicionales. RAG suele ser más práctico cuando la información cambia con frecuencia o es privada, porque actualizar los documentos es más simple que volver a entrenar un modelo.
¿Qué diferencia hay entre un AI Engineer y un Forward Deployed Engineer?
El AI Engineer desarrolla e integra soluciones basadas en inteligencia artificial para llevarlas a producción. El Forward Deployed Engineer (FDE) trabaja directamente con clientes para adaptar esas tecnologías a sus necesidades e implementar soluciones en entornos reales. Ambos combinan desarrollo e IA, pero el AI Engineer se centra en construir sistemas y el FDE en resolver problemas concretos del negocio mediante su implementación.
Si ya programas y quieres construir sistemas de AI que funcionen de verdad, conoce la carrera de AI Engineering en Henry y revisa el programa completo.